
前回、郵便物を全部スキャンしてLLMに読ませ、Google DriveとWikiに整理するパイプラインを作りました。が、ギブして良い情報もありつつ、物によってはいろいろとラインが怪しいものがあったのでローカルで完結するように作り直しました。
というわけで、書類を読む部分をまるごと家の中に引っ越しました。
構成
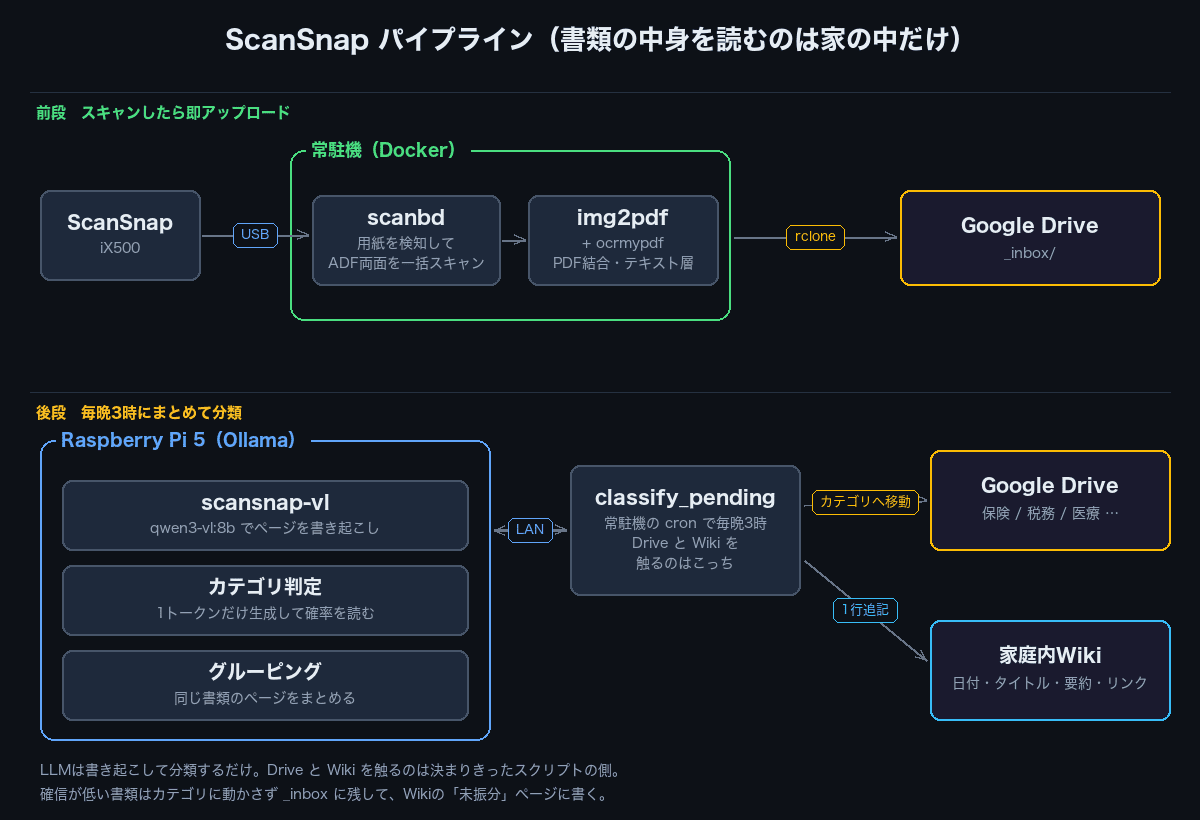
前回から変わったのは2つ。
- 書類を読むのがOpenAIのモデルからラズパイで動かしているのローカルVLMになった
- スキャンの取り込みと、分類・振り分けを前段・後段に分けた
分けたのは速度の都合で、ラズパイのCPUだと1ページ10分くらいかかる。1本のパイプラインにすると紙を挿してから書類がどこかに保存されるまで何時間も空いてしまうのでスキャンしたら現物をまず _inbox にアップロードして、中身を読むのは夜にまとめてやることにしました。
読ませるモデル
Raspberry Pi 5 の Ollama に qwen3-vl:8b を置いて、コンテキスト長や num_predict を焼き込んだ派生モデル scansnap-vl として使っている。リクエスト側でパラメータを渡し忘れて既定値に落ちる事故を防ぎたかった為です。
手元の書類(医療系の案内票とか検査結果の表とか)で実際に測った結果がこう。
| 文字誤り率 | キーワード再現率 | 1ページ | |
|---|---|---|---|
| tesseract | 0.133 | 0.652 | 0.3秒 |
| qwen3-vl:8b(ラズパイ) | 0.045 | 0.872 | 約10分 |
| 前回まで使っていたクラウドのモデル | 0.022 | 0.977 | 約28秒 |
tesseractは日本語の書類だとそもそも読めていない行が多くて、分類に回す材料にならなかった。夜間にまとめて回す前提なら10分/ページで困らないし、Wikiの索引とカテゴリ振り分けに使うぶんにはこの精度で十分いい感じでした。
ちなみに小さいモデルも試したけど、同じ行を延々と吐き続ける繰り返しループに落ちて出力が全部ゴミになった。qwen3-vl:8b でも検査結果の数値表みたいなページでたまに起きるので、繰り返しを検知したら途中で打ち切るようにしています。プロンプトでお願いしてもだめでした。
カテゴリは自己申告させない
分類はモデルに「このカテゴリだと思います、確信度0.98です」と言わせていたものの、この自己申告がまったく当てにならなかった。誤分類したページでも平気で0.95〜0.99を出してくるので、低確信度を _inbox に逃がすための閾値が一度も発動しない。
なので、ちょうど最近出てきたJevぽい形にすることにしました。カテゴリの選択肢に記号を振ってその記号を1トークンだけ生成させ、その位置の確率分布を読む方式に変えました。モデルが実際にその選択肢に置いている確率なので、閾値として意味を持つ。実際、住民票の裏面だけを見せたページは 行政 0.75 / unknown 0.25 になっていて結構機能してそうでした。
何より生成が1トークンになった分速度が早くなったのがかなり嬉しい。
確信度が低い書類はカテゴリに動かさず _inbox に残して、Wikiの「未振分」ページに書く。このときモデルの推測も suggested_category として残しておく。あとで人間が見るときのヒントを消してしまうと意味がないので。
処理の流れ
- 紙を挿すと scanbd が検知して scanadf で両面を一括スキャン
- img2pdf で1つのPDFにまとめて ocrmypdf でテキスト層を足す
- rclone で Google Drive の
_inbox/へアップロード(最後の紙を通してから1分待って取り込みが始まる) - 毎晩3時、cronが溜まったスキャンをラズパイに投げてページごとに書き起こし
- カテゴリを判定して、同じ書類のページをグルーピング
- カテゴリのフォルダへPDFを移動して、家庭内Wikiの索引に1行追記
LLMが担当するのは書き起こしと分類と要約部分。
今後
カテゴリの当て方はまだ雑で、車検の予約票が「DM・広告」に入ったりしている。選択肢の中にその書類に合うカテゴリが無いと、モデルは一番近そうなところに強い確信で押し込んでくるので、カテゴリ体系側のヒントを書き直していきたい。あとは _inbox に溜まった低確信度の書類をスマホからさっと振り分けられる導線を用意したい所。